

Was wir tun · Storage und Compute: Enterprise-SAN-Storage auf HPE 3PAR, All-Flash
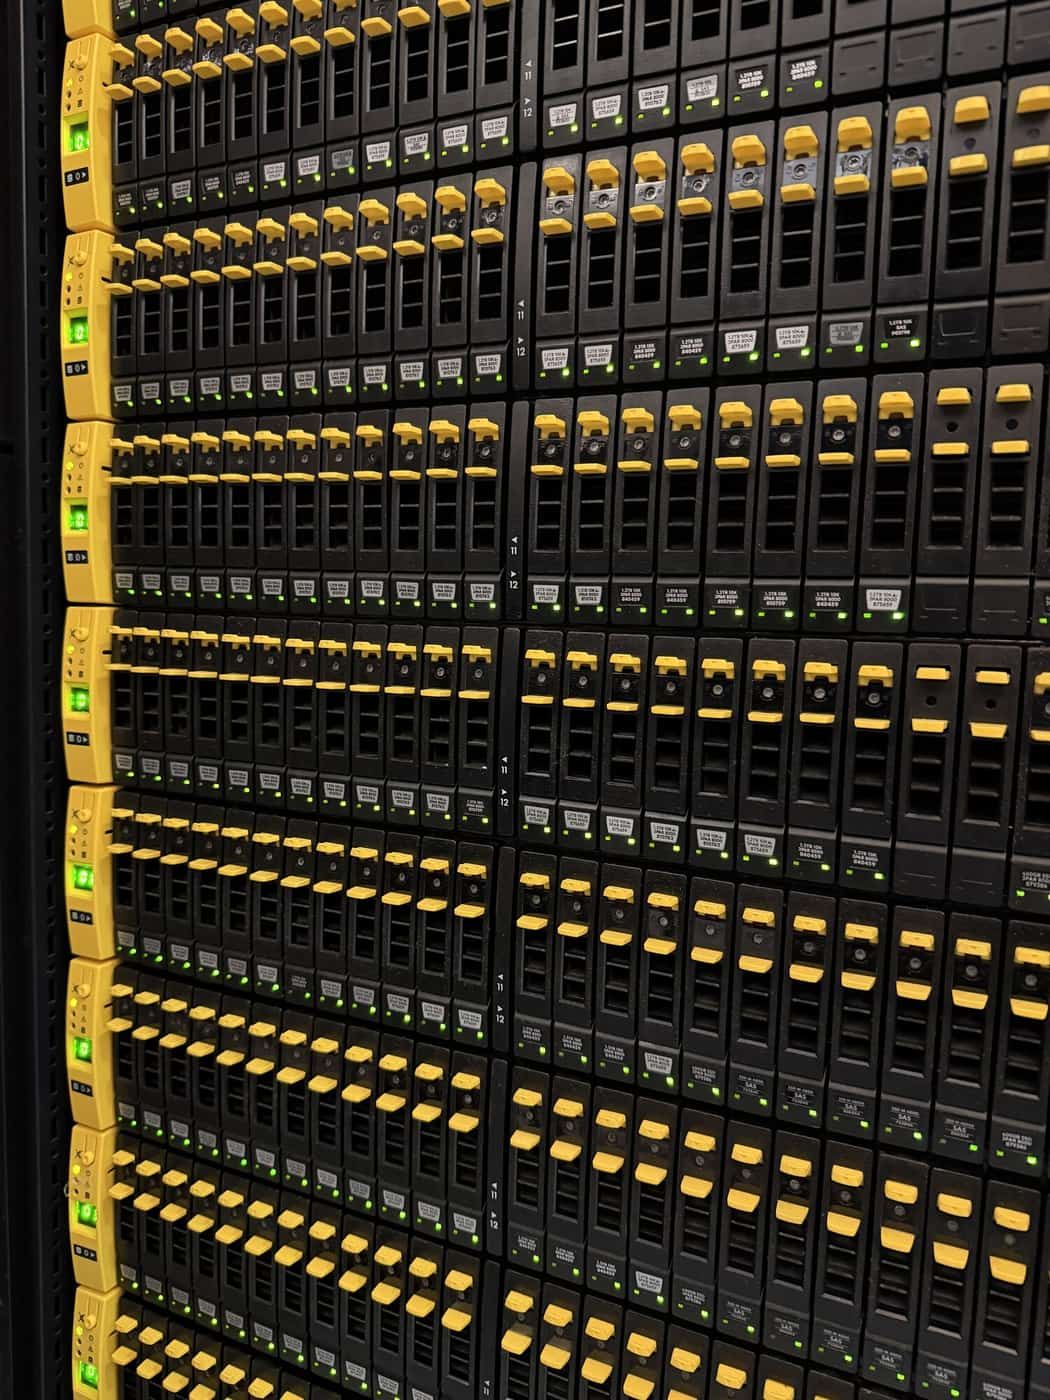
Jede virtuelle Maschine, jeder Datenbank-Host und jeder SAN-gebootete Server, den wir betreiben, hält seine Daten auf HPE 3PAR Enterprise-Arrays, All-Flash, erreicht über zwei unabhängige Fibre-Channel-Fabrics. Nicht auf den lokalen Platten eines einzelnen Servers. Ein Controller, ein Kabel, ein Switch oder ein Laufwerk kann ausfallen, und Ihr Volume bleibt online.
Was es ist
Blockspeicher von der Art, wie ihn Banken und Sendeanstalten kaufen: gemeinsam genutzte HPE 3PAR Arrays mit zwei Controllern und echtem Multipathing.
Wie wir es bauen
All-Flash, SSD RAID 6. Kunden-Volumes werden aus SSD-RAID-6-Provisioning-Gruppen bereitgestellt. RAID 6, weil der Rebuild eines großen Flash-Laufwerks Zeit braucht, und wir diese Zeit nicht einen weiteren Ausfall vom Datenverlust entfernt verbringen wollen.
Zwei Controller, zwei Fabrics. Jedes Array hat zwei Controller. Jeder Host ist über zwei physisch getrennte Brocade Fibre-Channel-Fabrics angebunden, ein HBA-Port in jede.
Thin Volumes, die die Wahrheit sagen. Volumes sind thin provisioniert mit automatischer Nullerkennung, und Discard ist durchgehend aktiviert, sodass Platz, den Ihr Gast freigibt, an das Array zurückgeht.
Arrays, die zusammenarbeiten. Unsere Arrays sind in Federation, sodass ein laufendes Volume von einem Array auf ein anderes verschoben werden kann, während Ihr Host weiter liest und schreibt.
Wovor es Sie schützt
- Davor, dass die lokalen Platten eines Servers mit Ihrem Betriebssystem und Ihren Daten darauf sterben.
- Davor, dass ein Storage-Controller, ein HBA-Port, eine Optik oder ein Switch einen Host von seinen Platten trennt.
- Davor, dass ein Laufwerk die Leistung lange vor seinem endgültigen Ausfall still verschlechtert.
- Davor, dass Storage-Wartung zu einem Wartungsfenster für Kunden wird.
- Davor, dass eine laute Workload die Latenz aller anderen nach unten zieht.
- Davor, dass Sie für eine Platte in voller Größe zahlen, die Sie nur zur Hälfte füllen.
In der Praxis
Laufwerke beim ersten korrigierten Fehler getauscht. Ein Laufwerk, das auch nur einen korrigierten Fehler meldet, verlässt sich unter laufendem Verkehr bereits auf seine interne Fehlerkorrektur, also tauschen wir es dann, nachdem wir es zuerst leer gezogen haben, statt auf den Ausfall zu warten.
Ein Datenbankcluster, der den Verlust eines Arrays übersteht. Für einen Analytics-Kunden, der eine geclusterte Datenbank zu uns umzog, wurde die Datenplatte jedes Clustermitglieds auf ein anderes physisches Array gelegt, als Thin Volumes in voller Größe präsentiert. Der Verlust eines ganzen Arrays kostet diesen Cluster nun ein Replikat, und er liefert weiter.
Warum EuroVPS
- Enterprise-Arrays von HPE, kein Software-RAID in derselben Kiste wie Ihre VM.
- All-Flash, RAID 6, zwei Controller und zwei getrennte Fibre-Channel-Fabrics als Grundausstattung, nicht als Upsell.
- Volumes, die live zwischen Arrays wandern können, damit unsere Wartung nie Ihr Ausfall ist.
- Laufwerke beim ersten Fehler getauscht, nicht beim letzten.
- Ingenieure, die messen, was Ihre Workload vom Array verlangt, und die wirkliche Ursache abstimmen.
Häufige Fragen
- Liegt meine VM-Platte auf lokalem Storage oder auf dem SAN? Auf dem SAN. Unsere Hypervisoren und SAN-gebooteten Server halten keine Kundendaten lokal, sodass ein ausgefallener Server ein Teiletausch ist und keine Datenrettung.
- Ist es wirklich All-Flash? Ja. Kunden-Volumes werden aus SSD-RAID-6-Gruppen bereitgestellt.
- Kann ich ein dediziertes Volume für meinen Bare-Metal-Server bekommen? Ja. Wir stellen dedizierten Servern Volumes über Fibre Channel bereit, Boot-Volumes eingeschlossen, mit demselben Multipathing wie bei unseren eigenen Hypervisoren.
- Zahle ich für den zugewiesenen oder den genutzten Platz? Volumes sind thin mit Nullerkennung, das Array verbraucht also nur Flash für geschriebene Daten. Ihr Tarif legt fest, was Ihnen zugewiesen ist.
- Machen Sie Snapshots von Volumes? Ja, Array-Snapshots sind Teil davon, wie wir Daten schützen und verschieben. Backups sind davon getrennt und Pull-only; siehe unsere Seite zu Disaster Recovery.
- closing line: Storage ist der Ort, an dem Abstriche gemacht werden, die niemand sieht, bis zu dem Tag, an dem sie zählen. Sprechen Sie mit einem Ingenieur darüber, Ihre Daten auf Arrays zu legen, die gebaut sind, um weiterzuliefern.
- CTA: Mit einem Ingenieur sprechen
Ihr nächster Infrastrukturpartner
Sehen wir uns Ihre Umgebung an.
Erzählen Sie uns, was Sie heute betreiben und was besser werden muss. Ein Ingenieur sieht Ihre Anfrage durch und hilft Ihnen, den nächsten Schritt zu planen.
+357 222 32280
Beginnen wir mit Ihrer Umgebung.
Ein wenig Kontext hilft uns, das richtige Gespräch zu beginnen.