

Τι να ελέγξετε σε έναν νέο server πριν αναλάβει παραγωγή
Έλεγχοι παραλαβής για έναν νέο dedicated server: μνήμη, δίσκοι, cache RAID, ανίχνευση flash, bonded links, διπλή τροφοδοσία και απομακρυσμένη πρόσβαση, με εντολές.
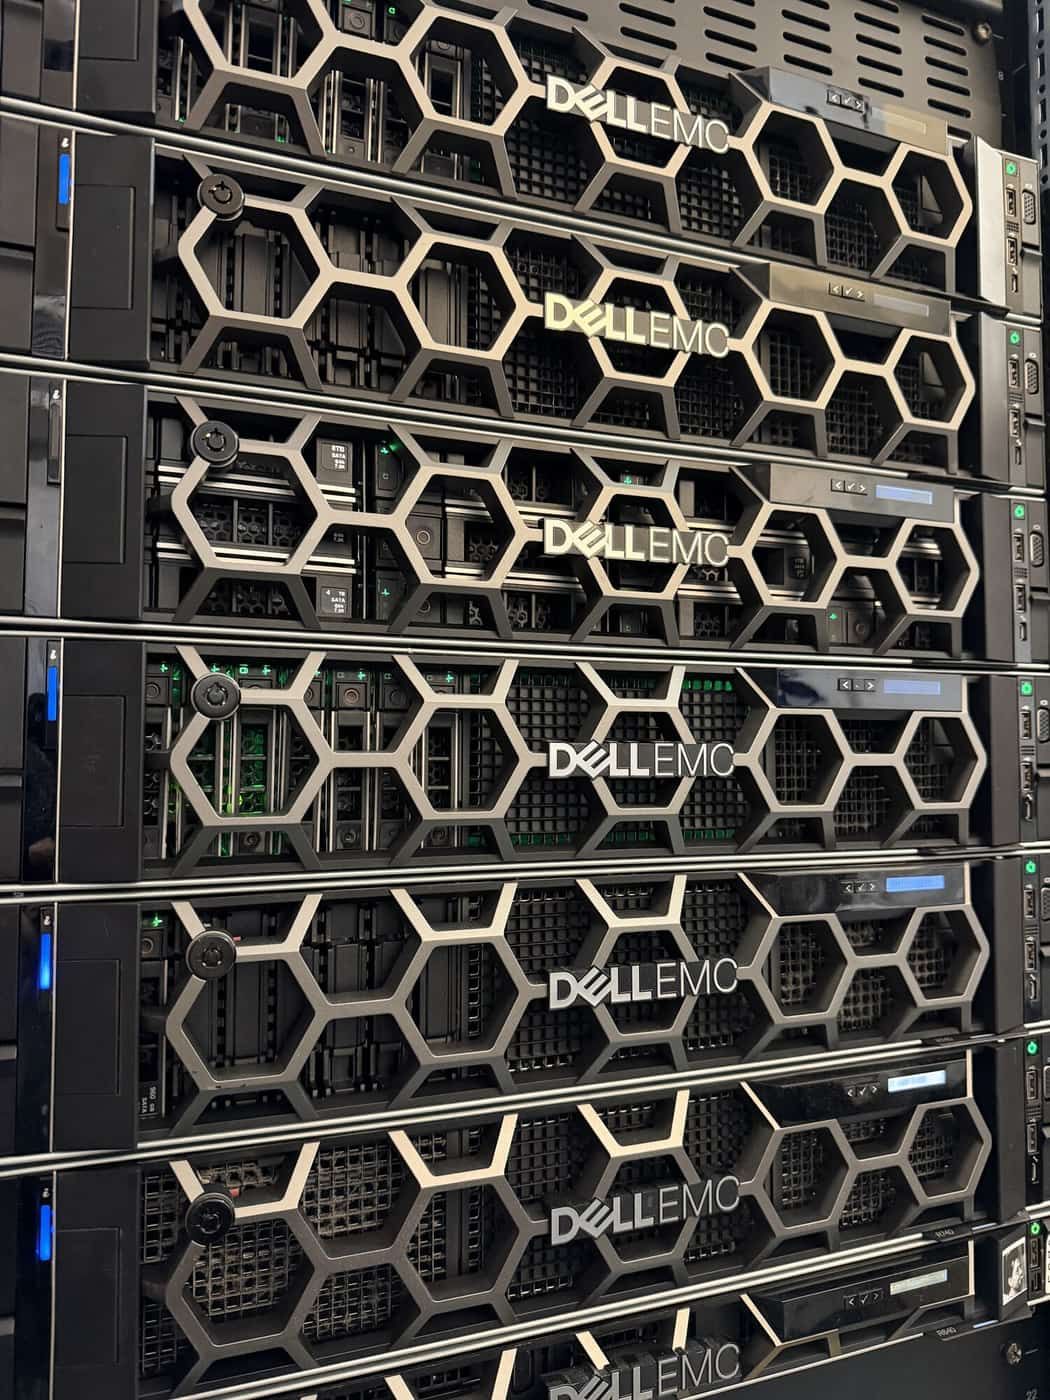
Ένας νέος dedicated server συνήθως φτάνει με ένα λειτουργικό σύστημα, ένα login και μια υπόθεση: ότι όλα όσα πληρώσατε είναι παρόντα, υγιή και ρυθμισμένα για χρήση. Τις περισσότερες φορές αυτό είναι σχεδόν αλήθεια. Το κενό ανάμεσα στο σχεδόν και στο πλήρως είναι από όπου έρχονται οι αργές βάσεις δεδομένων, οι αδρανείς συνδέσεις δικτύου και οι αιφνιδιαστικές διακοπές. Εδώ είναι ο έλεγχος παραλαβής που πιστεύουμε ότι αξίζει κάθε server πριν αναλάβει παραγωγή, με τις εντολές για να τον τρέξετε μόνοι σας.
Γιατί παραλείπεται ο έλεγχος παραλαβής
Ένας server που κάνει boot φαίνεται τελειωμένος. Το λειτουργικό σύστημα δεν παραπονιέται για μια μονάδα μνήμης που δεν βλέπει, για μια cache RAID που τρέχει χωρίς την μπαταρία της, ή για ένα bond που στέλνει κάθε πακέτο από μία σύνδεση. Καθένα από αυτά είναι αόρατο στην κανονική χρήση και ακριβό αργότερα, και καθένα παίρνει λεπτά για να ελεγχθεί την πρώτη μέρα. Μετά το go-live, οι ίδιοι έλεγχοι χρειάζονται παράθυρο συντήρησης.
Μνήμη: όλη, ισορροπημένη, χωρίς σφάλματα
Επιβεβαιώστε ότι το σύστημα βλέπει κάθε μονάδα που παραγγείλατε, και ότι κάθονται σε ισορροπημένη διάταξη στα κανάλια μνήμης κάθε επεξεργαστή. Μια μη ισορροπημένη διάταξη τρέχει, αλλά πιο αργά από όσο θα έπρεπε.
dmidecode -t memory | grep -E 'Size|Locator' | grep -v 'No Module'
free -h
ras-mc-ctl --errors
Διορθωμένα σφάλματα μνήμης στις πρώτες μέρες της ζωής ενός server είναι λόγος να αντικαταστήσετε μια μονάδα τώρα, όσο είναι εύκολο, όχι μια περιέργεια για να την παρακολουθείτε.
Δίσκοι και ο ελεγκτής RAID
Διαβάστε την υγεία κάθε δίσκου, συμπεριλαμβανομένων αυτών που κρύβονται πίσω από έναν hardware RAID controller, και την κατάσταση της write cache του ελεγκτή:
smartctl -a /dev/sda
smartctl -a -d megaraid,0 /dev/sda    # a drive behind a MegaRAID-family controller
storcli64 /c0 show all                # Dell PERC and LSI family
ssacli ctrl all show config detail    # HPE Smart Array
Ψάξτε για μη μηδενικούς μετρητές reallocated, pending ή media errors σε οποιονδήποτε δίσκο. Ένας νέος δίσκος με διορθωμένο σφάλμα είναι δίσκος του οποίου η δική του διόρθωση σφαλμάτων ήδη δουλεύει σκληρά. Στον ελεγκτή, επιβεβαιώστε ότι ο λογικός δίσκος είναι στο επίπεδο RAID που παραγγείλατε, ότι η cache είναι σε λειτουργία write-back και ότι η μπαταρία ή η μονάδα cache με flash αναφέρει υγιής. Ένας ελεγκτής που έχει πέσει σε write-through λόγω της μπαταρίας του μπορεί να κάνει μια συστοιχία SSD να μοιάζει με περιστρεφόμενο δίσκο.
Μετά μετρήστε την απόδοση στο άδειο volume πριν κρατήσει δεδομένα, με ένα εργαλείο όπως το fio, ώστε να έχετε μια γραμμή αναφοράς για να συγκρίνετε αργότερα.
Αντιμετωπίζεται το flash ως flash;
Οι hardware RAID controllers συχνά δεν περνούν το flag solid state στον kernel, οπότε ένα volume χτισμένο από SSD αναφέρεται ως περιστρεφόμενος δίσκος και παίρνει ρυθμίσεις για περιστρεφόμενα μέσα:
lsblk -d -o NAME,ROTA,SCHED,MODEL
cat /sys/block/sda/queue/read_ahead_kb
Αν το ROTA λέει 1 σε ένα volume που ξέρετε ότι είναι flash, επιβεβαιώστε πρώτα τον τύπο μέσου από τον ελεγκτή, και μετά διορθώστε το με έναν κανόνα udev ώστε να επιβιώνει τις επανεκκινήσεις:
# /etc/udev/rules.d/60-ssd-tunings.rules
ACTION=="add|change", KERNEL=="sda", ATTR{queue/rotational}="0"
ACTION=="add|change", KERNEL=="sda", ATTR{queue/scheduler}="mq-deadline"
ACTION=="add|change", KERNEL=="sda", ATTR{queue/read_ahead_kb}="16"
ACTION=="add|change", KERNEL=="sda", ATTR{queue/nr_requests}="1024"
udevadm control --reload && udevadm trigger --action=change /sys/block/sdaΜην το εφαρμόσετε σε volume πάνω σε σκληρούς δίσκους. Το κοντό read ahead ταιριάζει στο flash και βλάπτει τις σειριακές αναγνώσεις από περιστρεφόμενα μέσα.
Δίκτυο: δύο συνδέσεις, και οι δύο σε λειτουργία
Ένας server με δύο bonded πόρτες συχνά χρησιμοποιεί μόνο τη μία. Το προεπιλεγμένο transmit hash του bonding driver του Linux κοιτά μόνο διευθύνσεις MAC, και σε ένα datacenter, όπου ένας host μιλά με μια χούφτα MAC gateways και peers, αυτό μπορεί να βάλει σχεδόν κάθε ροή στην ίδια σύνδεση.
cat /proc/net/bonding/bond0
ethtool -S <first port> | grep -E 'tx_packets|rx_packets'
ethtool -S <second port> | grep -E 'tx_packets|rx_packets'
Ελέγξτε ότι και τα δύο μέλη είναι up, ότι το LACP έχει συνεργαστεί με το switch, και ότι η πολιτική hash είναι αυτή που σκοπεύατε. Υπό φορτίο, οι μετρητές και των δύο μελών πρέπει να αυξάνονται με παρόμοιο ρυθμό. Για τους περισσότερους servers, το hashing σε διευθύνσεις IP και πόρτες μοιράζει την κίνηση πολύ καλύτερα:
nmcli con mod bond0 bond.options "mode=802.3ad,miimon=100,lacp_rate=slow,xmit_hash_policy=layer3+4"Ταιριάξτε την πλευρά του switch με αυτό, ώστε η κίνηση να μοιράζεται με τον ίδιο τρόπο και προς τις δύο κατευθύνσεις. Μετά τραβήξτε ένα καλώδιο, επιβεβαιώστε ότι ο server παραμένει προσβάσιμος, βάλτε το πίσω, και επαναλάβετε με το άλλο.
Τροφοδοσία, ώρα και απομακρυσμένη πρόσβαση
ipmitool sdr type "Power Supply"
chronyc tracking
getenforce
Και τα δύο τροφοδοτικά πρέπει να είναι παρόντα και τροφοδοτούμενα, και πρέπει να τροφοδοτούνται από διαφορετικές γραμμές ρεύματος. Ένας server με δύο τροφοδοτικά στην ίδια γραμμή έχει ένα μοναδικό σημείο αποτυχίας με επιπλέον βήματα. Επιβεβαιώστε ότι ο out of band ελεγκτής (iLO, iDRAC ή IPMI) είναι προσβάσιμος στο δίκτυο διαχείρισής του και έχει άδεια για την απομακρυσμένη κονσόλα που θα χρειαστείτε. Αν το SELinux είναι μέρος του προτύπου σας, επιβεβαιώστε ότι είναι enforcing πριν εγκατασταθεί η πρώτη εφαρμογή, όχι μετά.
Γράψτε το
Ο τελευταίος έλεγχος είναι η τεκμηρίωση: σειριακός αριθμός, θέση στο rack, κάθε πόρτα με τη διεύθυνση MAC της και πού συνδέεται, κάθε διεύθυνση IP, και οι δύο γραμμές ρεύματος και τα cable IDs.
Πώς το κάνουμε εμείς
Οι dedicated servers μας είναι πλατφόρμες HPE ProLiant και Dell PowerEdge, με out of band διαχείριση σε απομονωμένο δίκτυο. Κάθε RAID build περνά έλεγχο υγείας δίσκων και δοκιμή απόδοσης πριν παραδοθεί. Το flash πίσω από RAID controller παίρνει τις παραπάνω ρυθμίσεις, με βάση τον τύπο μέσου που διαβάζεται από τους δίσκους. Κάθε bond κάνει hash σε διευθύνσεις και πόρτες, με το switch να ταιριάζει. Ελέγχουμε τους μετρητές ανά πόρτα για να αποδείξουμε ότι και οι δύο συνδέσεις μεταφέρουν κίνηση.
Αν έχετε έναν server ήδη σε παραγωγή που δεν πέρασε ποτέ αυτόν τον έλεγχο, δεν είναι αργά, και ευχαρίστως να τον περάσουμε μαζί σας.
CTA
Related
Σχετικά: Bare metal servers σε HPE και Dell · Μηχανική επιδόσεων και χωρητικότητας · Enterprise SAN storage σε HPE 3PAR, all-flash
Δημοσιεύθηκε 28 Σεπτεμβρίου 2026.
Όλες οι σημειώσεις