

Conectar PHP a Valkey Sentinel, y demostrar que el failover funciona
Una caché replicada solo ayuda si PHP sigue la promoción. Cómo montar Sentinel, conectar WordPress y Laravel, elegir una política de eviction y probarlo.
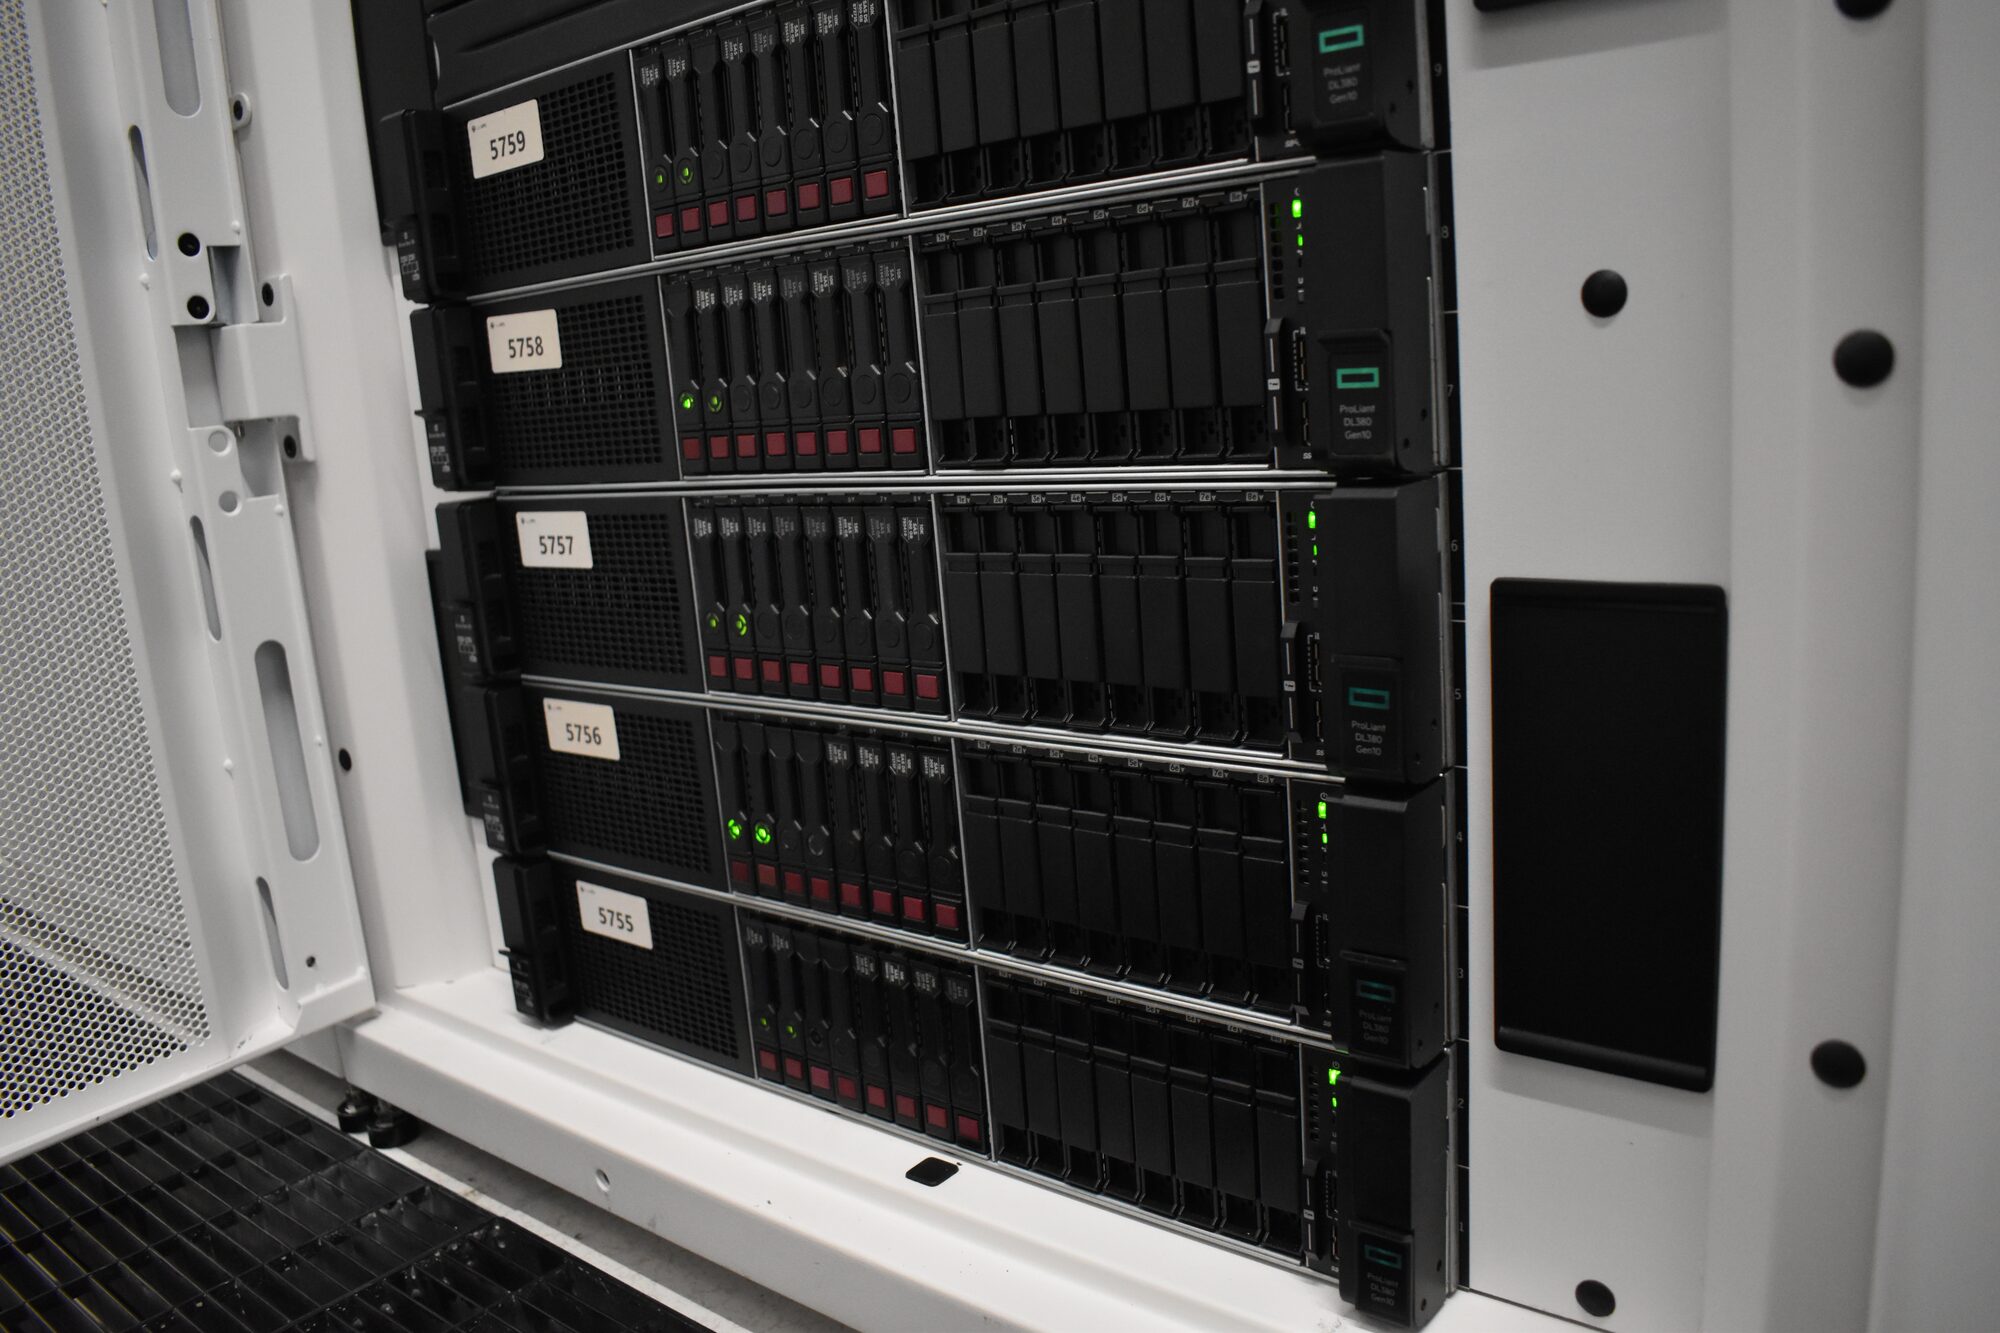
Muchos sitios ejecutan una caché Redis o Valkey replicada y aun así se caen cuando muere el primario, porque la aplicación apunta a una dirección fija. Las réplicas están ahí, Sentinel promociona una, y PHP sigue llamando a la puerta del servidor muerto. Así se construye la caché para que el failover llegue de verdad a la aplicación, y así se demuestra antes de necesitarlo.
Por qué la caché forma parte de su disponibilidad
Una caché de objetos guarda resultados ya calculados: opciones, menús, sesiones, resultados de consultas, fragmentos renderizados. En un sitio WordPress, Magento o Laravel con tráfico absorbe la mayor parte de la carga de lectura de la base de datos. Piérdala, y todas las peticiones vuelven a la base de datos a la vez. La base de datos nunca se dimensionó para eso, así que el sitio se arrastra en cuestión de minutos. Una sola instancia de caché es por tanto un punto único de fallo, aunque no guarde nada que no se pueda reconstruir.
La forma: un primario, dos réplicas, tres Sentinels
Ejecute tres nodos de caché en tres hosts distintos: un primario y dos réplicas. Junto a cada uno, ejecute un proceso Sentinel. Los Sentinels vigilan el primario, se ponen de acuerdo entre ellos cuando ha desaparecido, promocionan una réplica y responden a la pregunta que todo cliente necesita respondida: ¿dónde está ahora el primario?
En cada réplica:
replicaof <primary-address> 6379
masterauth <secret>
requirepass <secret>
Y en cada uno de los tres Sentinels:
sentinel monitor cache <primary-address> 6379 2
sentinel auth-pass cache <secret>
sentinel down-after-milliseconds cache 5000
sentinel failover-timeout cache 30000
sentinel parallel-syncs cache 1
El 2 de la línea monitor es el quórum: dos de los tres Sentinels deben coincidir en que el primario está caído antes de que empiece un failover. Por eso hay tres, en tres hosts distintos.
down-after-milliseconds es el equilibrio entre rapidez y cautela. Nosotros lo mantenemos corto. Un failover innecesario cuesta unos segundos de fallos de caché; una espera larga con un primario muerto cuesta una base de datos arrastrándose.
El paso que la gente se salta: clientes que preguntan a Sentinel
Un cliente configurado con la dirección del primario nunca se enterará de una promoción. La aplicación debe conectarse a través de Sentinel, por nombre de servicio, y preguntar por el primario actual.
Con phpredis directamente:
$sentinel = new RedisSentinel(['host' => '<sentinel-1>', 'port' => 26379]);
[$host, $port] = $sentinel->getMasterAddrByName('cache');
$redis = new Redis();
$redis->connect($host, (int) $port);
$redis->auth('<secret>');
El código de producción debería probar cada Sentinel por turno, ya que cualquiera de ellos puede estar en el host que acaba de fallar.
Para WordPress, el drop-in Redis Object Cache, muy extendido, soporta Sentinel de forma nativa en wp-config.php:
define('WP_REDIS_CLIENT', 'phpredis');
define('WP_REDIS_SENTINEL', 'cache');
define('WP_REDIS_SERVERS', [
    'tcp://<sentinel-1>:26379',
    'tcp://<sentinel-2>:26379',
    'tcp://<sentinel-3>:26379',
]);
define('WP_REDIS_PASSWORD', '<secret>');
Laravel, a través de Predis, acepta una lista de Sentinels y dos opciones en config/database.php:
'redis' => [
    'client' => 'predis',
    'default' => [
        'tcp://<sentinel-1>:26379',
        'tcp://<sentinel-2>:26379',
        'tcp://<sentinel-3>:26379',
        'options' => ['replication' => 'sentinel', 'service' => 'cache'],
    ],
],
Con esto en su sitio, una promoción no necesita ningún cambio de configuración ni reiniciar PHP.
Memoria: póngale un tope y elija a quién se expulsa
Una caché que crece hasta que interviene el OOM killer del kernel ha fallado de la peor manera posible. Fije maxmemory en una fracción fija de la RAM del nodo, dejando sitio para los buffers de replicación y el fork que usa la persistencia, y elija una política de eviction a propósito:
allkeys-lrupara una caché pura. Cuando la memoria se llena, se va la clave usada menos recientemente, sea cual sea. Es lo correcto para cachés de objetos.volatile-lrusi la instancia también guarda claves sin caducidad que nunca deben expulsarse, como las sesiones. Solo las claves con TTL son candidatas.
Mejor aún, mantenga separadas las sesiones y la caché de objetos. Un despliegue que vacía la caché de objetos nunca debería cerrar la sesión de todos los clientes. En un clúster compartido, dé a cada sitio como mínimo su propia base de datos lógica; a los sitios grandes o críticos, su propia instancia, para que el vaciado o el crecimiento desbocado de claves de un sitio no pueda vaciar las cachés de sus vecinos.
Demuéstrelo: mate el primario a propósito
Un failover que no ha visto es una esperanza. Antes de la entrega, ejecutamos esto con la aplicación conectada y tráfico en marcha:
# 1. Who is primary right now?
valkey-cli -p 26379 SENTINEL get-master-addr-by-name cache

# 2. Watch the site from outside, timestamped
while true; do
  printf '%s ' "$(date +%T.%N)"
  curl -s -o /dev/null -w '%{http_code} %{time_total}\n' https://www.example.com/
  sleep 0.5
done | tee cache-failover.log

# 3. On the primary's host, stop the cache service
systemctl stop valkey

# 4. Watch the Sentinel log for +switch-master, then ask again
valkey-cli -p 26379 SENTINEL get-master-addr-by-name cache
(Con Redis, los comandos son los mismos bajo redis-cli.)
Anote tres cosas: cuánto tarda en aparecer +switch-master, cuánto tardan los tiempos de página en volver a la normalidad, y si alguna petición falló en lugar de simplemente ralentizarse. Una construcción sana promociona en pocos segundos, y PHP la sigue sin que nadie lo toque. Después vuelva a arrancar el primario antiguo y confirme que se reincorpora como réplica del nuevo, no como un segundo primario.
Para un ensayo más suave que no detiene ningún servicio, SENTINEL FAILOVER cache fuerza una promoción bajo demanda. Útil para probar el lado del cliente; menos útil para probar la detección, que es la parte que importa en una mala noche.
Su lista de comprobación
- Tres nodos de caché y tres Sentinels en tres hosts distintos, quórum de dos.
- Autenticación activada, y la caché accesible solo desde la capa web que la usa.
- Toda aplicación conectándose a través de Sentinel por nombre de servicio, no a una dirección fija.
maxmemoryfijado y una política de eviction elegida según lo que guarda la instancia.- Sesiones separadas de la caché de objetos; sitios grandes aislados de los pequeños.
- Una prueba de failover registrada con la aplicación conectada, incluida la reincorporación del primario antiguo.
Si quiere que montemos o probemos su capa de caché, lo hacemos con gusto.
Related (rows[1])
Relacionado: Caché de objetos con failover automático · Capas web de alta disponibilidad, N+1 en cada nivel · Construcción de plataformas de alta disponibilidad
Publicado el 18 de agosto de 2026.
Todas las notas de campo